
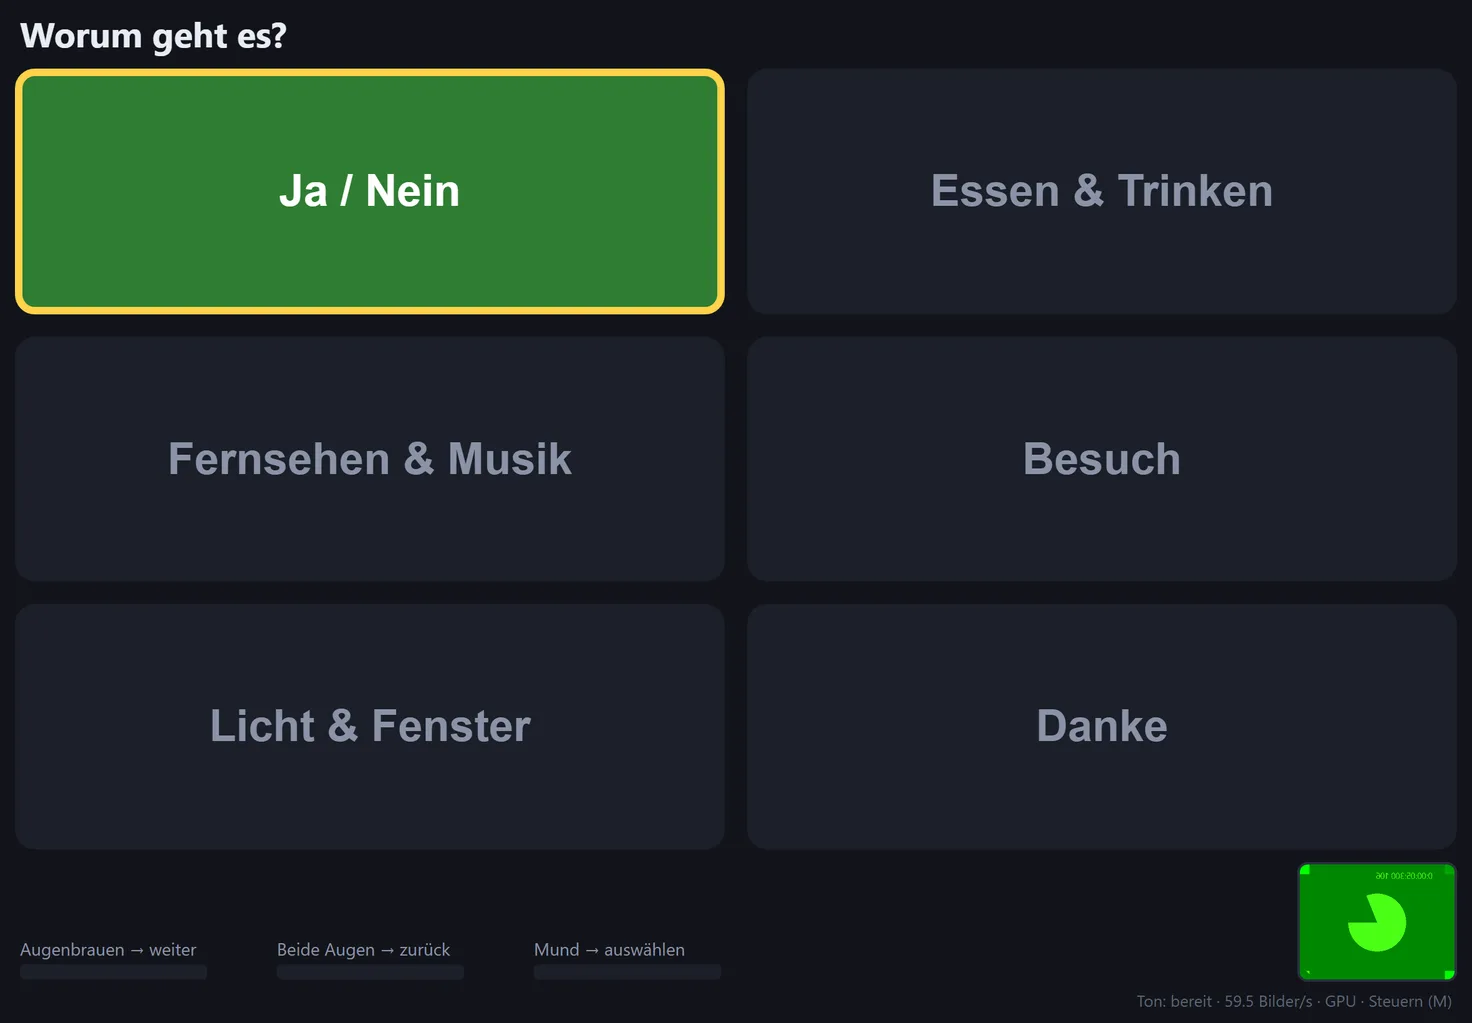
Warum selbst bauen
Ein Sprachcomputer über die Krankenkasse braucht einen Antrag, und der dauert. Eine Zwischenlösung musste schneller da sein. Bevor ich etwas gebaut habe, stand die wichtigste Frage: Welche Bewegung kann er zuverlässig wiederholen, ohne zu ermüden? Ein einfacher Taster schlägt jede Kameralösung an Zuverlässigkeit. Wo kein Taster mehr geht, bleibt das Gesicht.
Die Steuerung
| Signal | Wirkung |
|---|---|
| Augenbrauen heben | eine Kachel weiter |
| beide Augen schließen | eine Kachel zurück |
| Mund öffnen | auswählen |
Die Erkennung misst die Gesichtsbewegungen über die Kamera, mit MediaPipe. Bei jeder Bewegung der Markierung klickt es, hell für weiter und tief für zurück. Das war ein Wunsch nach dem ersten Test: Wer zum Zurückgehen die Augen schließt, sieht nicht, ob die Tafel reagiert hat. Für jemanden, dem nur noch ein einziges Signal bleibt, gibt es zusätzlich das Abtasten: Die Markierung wandert von selbst, und ein Signal wählt aus.
Die Entscheidungen, auf die es ankam
Ein Eingang, egal woher
Das Programm kennt ein einziges Eingangssignal: „jetzt“. Ob es von einer Taste, einem Fußtaster oder der Kamera kommt, ist ihm gleich. Wenn sich die Fähigkeiten ändern, und das werden sie, muss am Programm nichts geändert werden.
Ausgelöst wird beim Loslassen
Die erste Fassung löste aus, sobald ein Signal die Schwelle überschritt. Eine Simulation zeigte, was das bedeutet hätte: Zehn Sekunden Augen zu ergaben acht Auslösungen. Wer die Augen zum Ausruhen schließt, hätte alle paar Sekunden einen Satz gesprochen. Jetzt zählt ein Signal erst beim Loslassen und nur, wenn es zwischen einer halben und zweieinhalb Sekunden gehalten wurde. Blinzeln und längeres Ausruhen lösen nichts mehr aus, bewusste Signale weiter genau einmal.
Kleine Dinge, die im Alltag zählen
Schon die erste Fassung begann nach einer Auswahl wieder oben, damit die wichtigsten Sätze am schnellsten erreichbar sind, und hatte einen dunklen Hintergrund, weil die Tafel stundenlang im Blickfeld steht. Fehlt eine Tondatei, steht das auf dem Bildschirm. Sonst wählt jemand ein Feld, und nichts passiert, ohne dass der Grund sichtbar wäre.
Drei Geräte ausprobiert
- Windows-Rechner mit Python. Lief, aber simulierte Tastendrücke kamen nicht an, wenn ein anderes Fenster vorn lag. Jetzt liest die Tafel die Signale direkt aus der Erkennung, egal welches Fenster vorn ist.
- Raspberry Pi 3. Gemessen mit Tafel und Erkennung gleichzeitig: zwei Bilder pro Sekunde, ohne dass der Pi gedrosselt hätte. Zu langsam für eine Steuerung, also verworfen und nicht weiter optimiert.
- iPad im Browser. Dieselbe Logik als Webseite, die Erkennung läuft mit MediaPipe direkt im Browser. Im Test im Browser auf meinem Rechner liefen 23 bis 27 Bilder pro Sekunde. Auf dem iPad: „Die Steuerung funktioniert gut.“
Programm, Erkennungsmodell und Tondateien liegen alle auf meinem eigenen Server, hinter einem Passwort. Nichts wird von Google nachgeladen, und das Kamerabild bleibt auf dem Gerät.
Beim ersten Test am iPad kam kein Ton, weil das iPad stumm geschaltet war. Ein Fehler beim Abspielen wäre trotzdem unsichtbar geblieben, denn die Kameraschleife löschte jede Tonmeldung nach Sekundenbruchteilen. Jetzt steht der Tonzustand dauerhaft auf dem Bildschirm. Ein Programm darf scheitern, aber nicht schweigen.
Was es nicht ist
Es ist kein Medizinprodukt und ersetzt keinen Sprachcomputer von der Kasse. Getestet habe bisher vor allem ich an mir selbst. Die echten Sätze bleiben privat, auf dem Bild oben steht Beispielinhalt.
Technik
| Teil | Womit |
|---|---|
| Erkennung | MediaPipe Face Landmarker mit Blendshapes, im Browser als WebAssembly mit GPU |
| Tafel | HTML und JavaScript, Kategorien und Sätze aus einer JSON-Datei, Ton als vorab erzeugte Audiodateien |
| Erste Fassung | Python mit tkinter auf Windows, die Erkennung als eigener Prozess |
| Betrieb | nginx auf dem Raspberry Pi 5, mit Passwortschutz und HTTPS |