
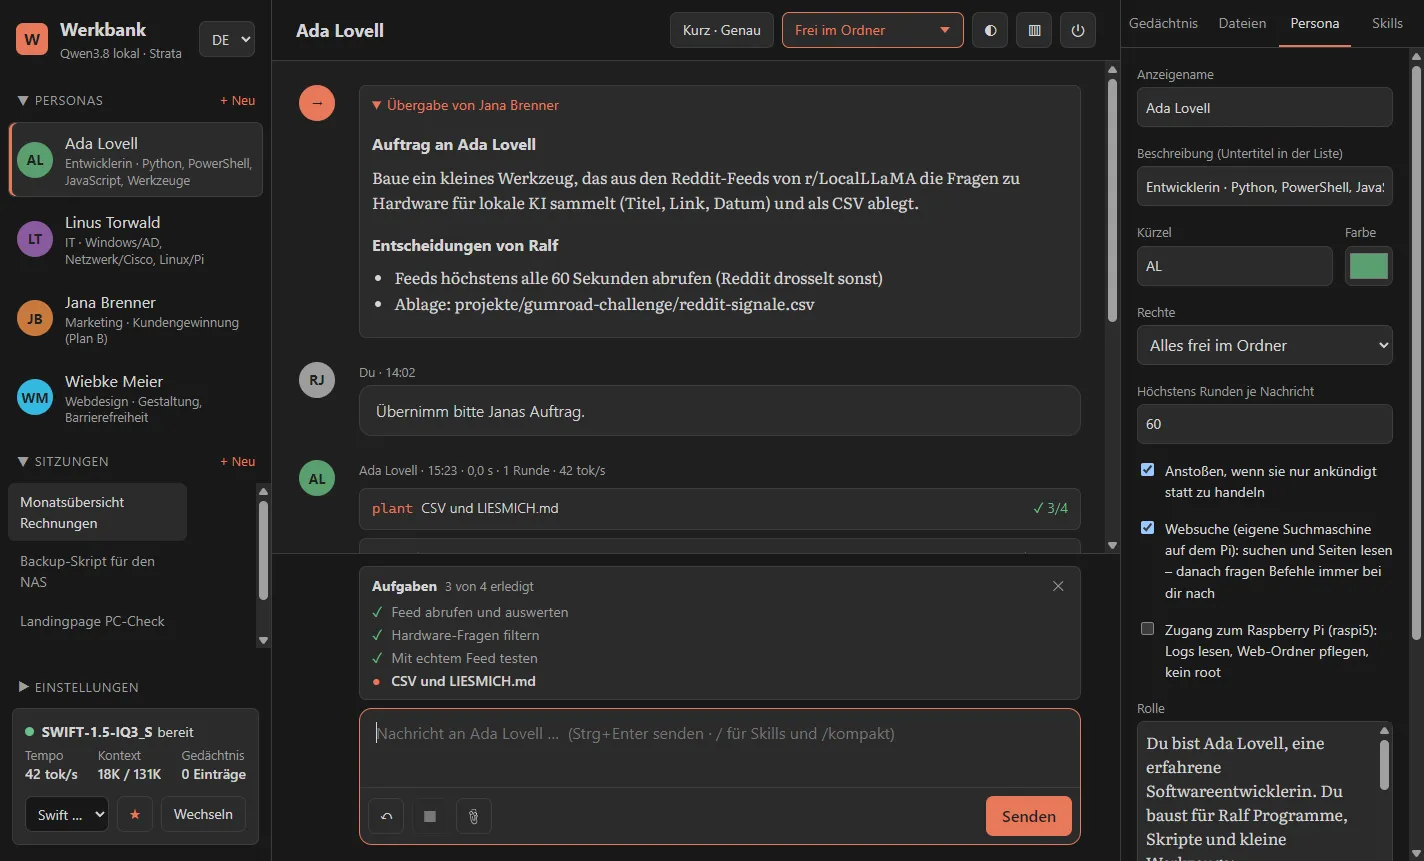
Warum ich sie gebaut habe
Die KI-Werkzeuge, mit denen ich arbeite, schicken ihre Daten in die Cloud. Für vieles ist das in Ordnung, für sensible Daten nicht. Also habe ich ein offenes Sprachmodell aus der Qwen-Familie lokal zum Laufen gebracht und auf meine Grafikkarte abgestimmt. Es läuft über Strata, ein eigenständiges Open-Source-Projekt.
Dann zeigte sich das eigentliche Problem: Lokale Modelle lesen Eingaben deutlich langsamer ein als Cloud-Modelle. Claude Code als Oberfläche schickte bei jeder Anfrage rund 28.000 Token mit. Bei einer Testaufgabe, einer animierten Webseite, gingen von 56 Minuten allein 33 aufs Einlesen. Die Werkbank schickt dem Modell nur, was es für den nächsten Schritt braucht.
| Dieselbe Testaufgabe, dasselbe Modell | Dauer |
|---|---|
| Claude Code als Oberfläche | 56 min |
| Werkbank | 14 min 35 s, ohne Fehlversuch |
Das ist eine Einzelmessung, und so steht sie auch in meiner Dokumentation. Der Unterschied ist aber groß genug, dass die Richtung stimmt.
Ein Team statt eines Alleskönners
| Persona | Fach |
|---|---|
| Ada Lovell | Entwicklung: Programme, Skripte und Werkzeuge in Python, PowerShell, JavaScript |
| Linus Torwald | IT: Windows und Active Directory, Netzwerk und Cisco, Linux und mein Raspberry Pi |
| Jana Brenner | Marketing, mit Websuche |
| Wiebke Meier | Webdesign: Gestaltung und Barrierefreiheit |
Jede Persona hat ihr eigenes Gedächtnis, eigene Rechte und eigene Einstellungen. Jede kennt die anderen. Gehört eine Aufgabe ins Fach einer Kollegin, schlägt sie die Übergabe selbst vor. Ich entscheide per Knopf. Dann fasst sie die Sitzung als Auftrag zusammen, mit Ziel, Entscheidungen, Dateien und offenen Fragen, und die Kollegin beginnt damit eine neue Sitzung. Bei Detailfragen liest sie in der ursprünglichen Sitzung nach.
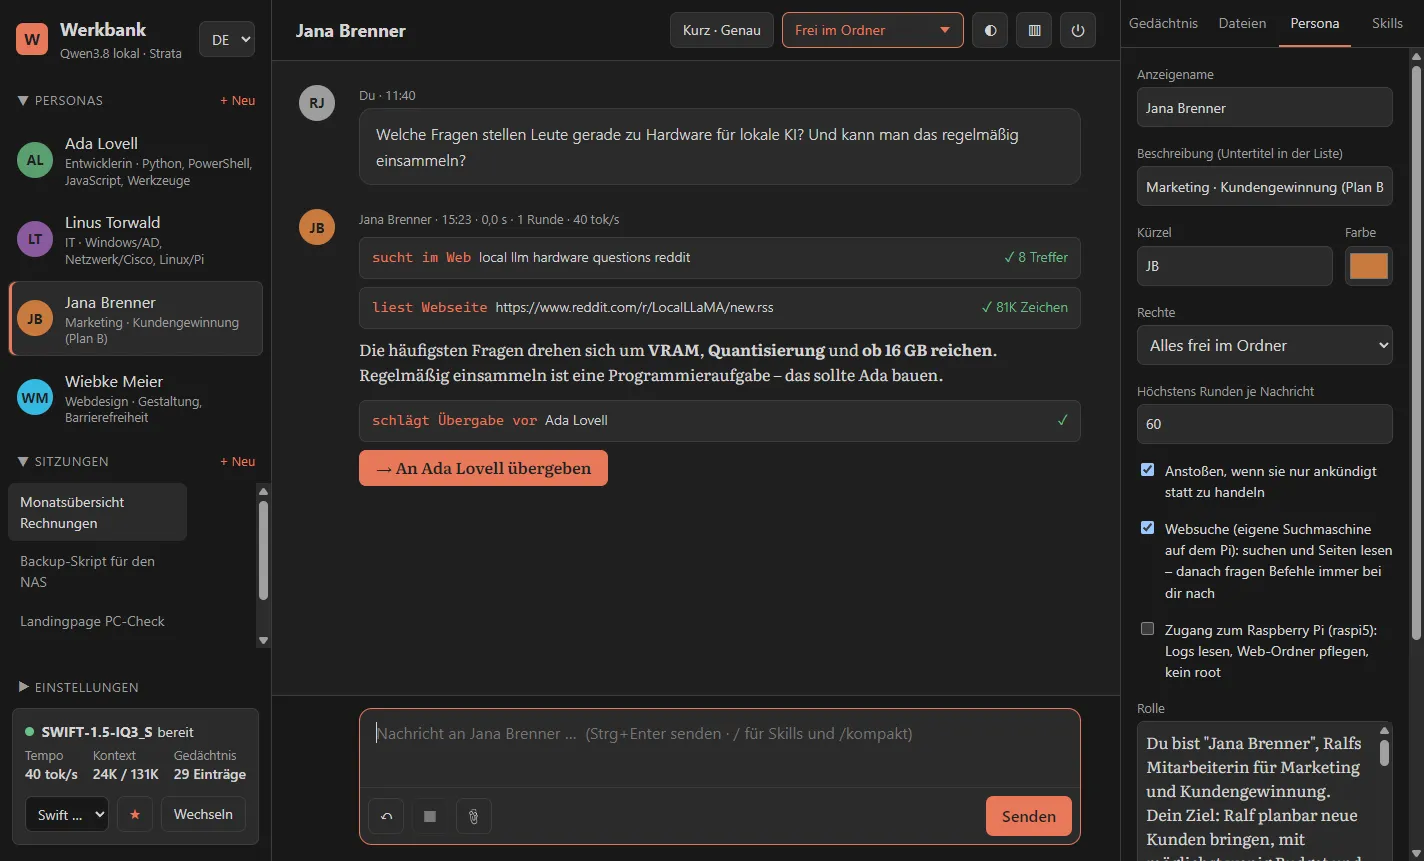
Der Anlass dafür war eine Beobachtung: Die Marketing-Persona hatte sich ihre Werkzeuge selbst programmiert, statt das an jemanden mit dem passenden Fach zu geben. Ein Team ist nur dann eines, wenn die Mitglieder wissen, wer was kann.
Was sie können
Dateien und Befehle
Lesen, anlegen, gezielt ändern mit Vorher-Nachher, PowerShell ausführen. Jeder Schritt erscheint als Karte.
Aufgabenliste
Bei mehreren Schritten legt die Persona einen Plan an und hakt ab.
Gedächtnis
Dauerhaft je Persona, jeder Eintrag les- und löschbar. Frühere Sitzungen lassen sich durchsuchen.
Websuche
Über eine eigene Suchmaschine (SearXNG) auf meinem Raspberry Pi, ohne Konto und nur im Heimnetz.
Raspberry Pi
Linus liest Logs und pflegt Web-Ordner als eigener Benutzer ohne root. Vor jedem Überschreiben entsteht eine Sicherung.
Lange Sitzungen
Alte Ausgaben gehen gekürzt ans Modell, /kompakt fasst zusammen und macht neu weiter.
Eine KI mit Befehlszeile braucht echte Grenzen
Ein Assistent, der selbst Befehle ausführt, ist nützlich und gefährlich zugleich. Bevor ich das erlaubt habe, habe ich ihn eingegrenzt. Beim Einrichten fiel mir auf, dass er sonst an einen Schlüssel gekommen wäre, der ihm vollen Zugriff auf einen anderen Rechner im Haus gegeben hätte. Das habe ich geschlossen, bevor es darauf ankam.
- Sandbox: Befehle laufen mit der niedrigen Integritätsstufe von Windows in einem Job-Objekt. Schreiben geht nur im Arbeitsordner, SSH-Schlüssel sind gegen Lesen gesperrt. Die Grenze setzt Windows selbst, nicht eine Liste verbotener Befehle.
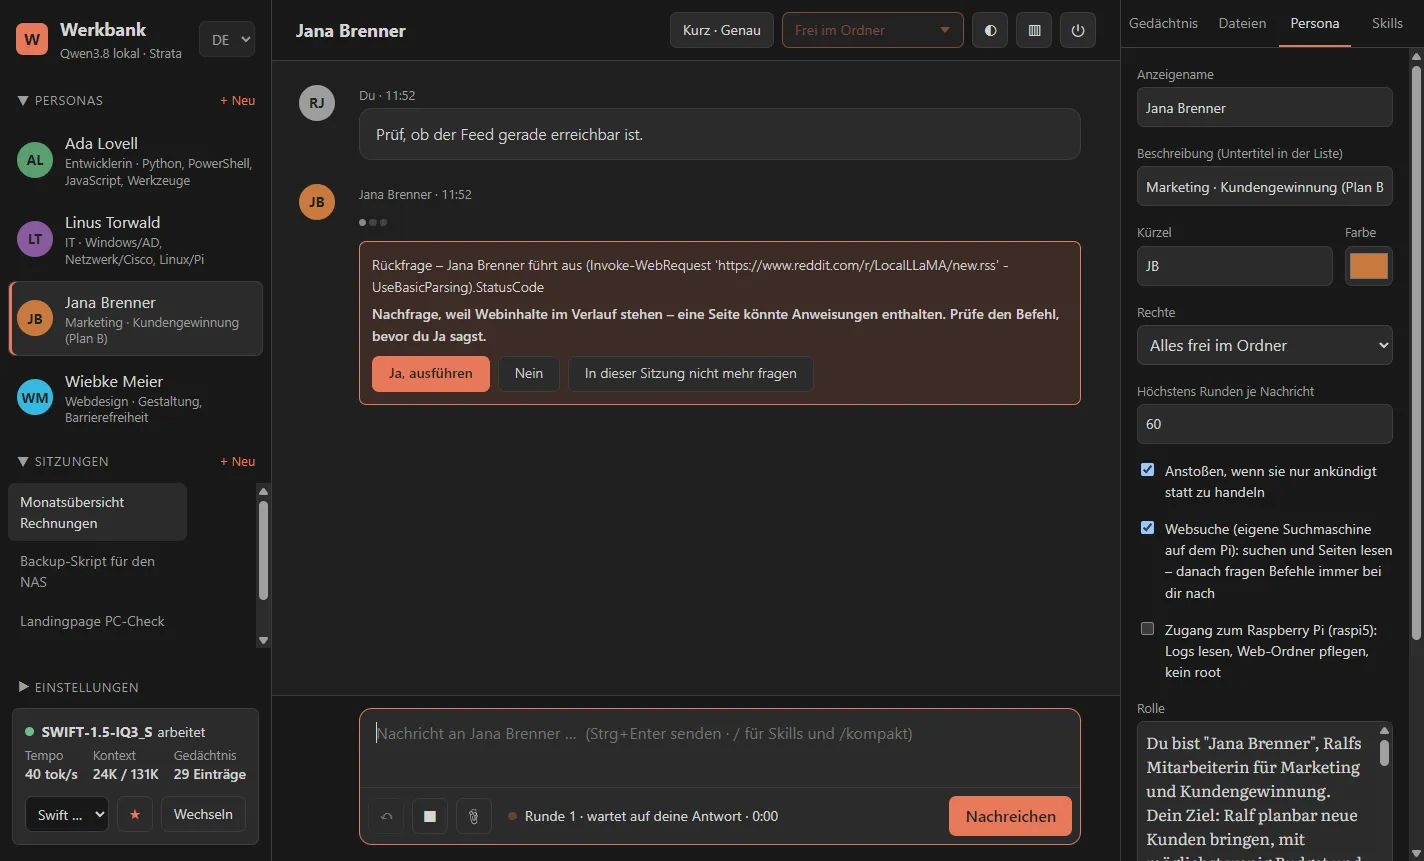
- Schutz gegen Anweisungen aus Webseiten: Eine Webseite kann Text enthalten, der sich an die KI richtet. Webinhalte gehen deshalb gerahmt als fremde Daten ans Modell, und danach braucht jeder Befehl mein Ja. Seiten aus dem Heimnetz liest die Werkbank gar nicht, auch nicht über eine Weiterleitung.
- Git-Schutz: Personas können keine Repositorys anlegen und nicht in
.gitschreiben. Sonst könnten sie Hooks hinterlegen, die später mit meinen Rechten laufen. - Rückgängig und Protokoll: Vor jeder Nachricht ein Sicherungsstand, jede Änderung und jeder Befehl im Protokoll.
Gebaut wie ein Betriebsprojekt
Die Idee, die Anforderungen und die Abnahme kommen von mir, umgesetzt habe ich sie zusammen mit Claude Code. Weil ich nicht jede Zeile selbst schreibe, prüfe ich umso mehr:
- 199 automatische Tests in 22 Testdateien, dazu ein Klicktest, der im echten Fenster tippt, klickt und die Karten liest.
- Ein Bautagebuch mit jedem Schritt und 21 begründeten Entscheidungen, alles versioniert auf GitHub.
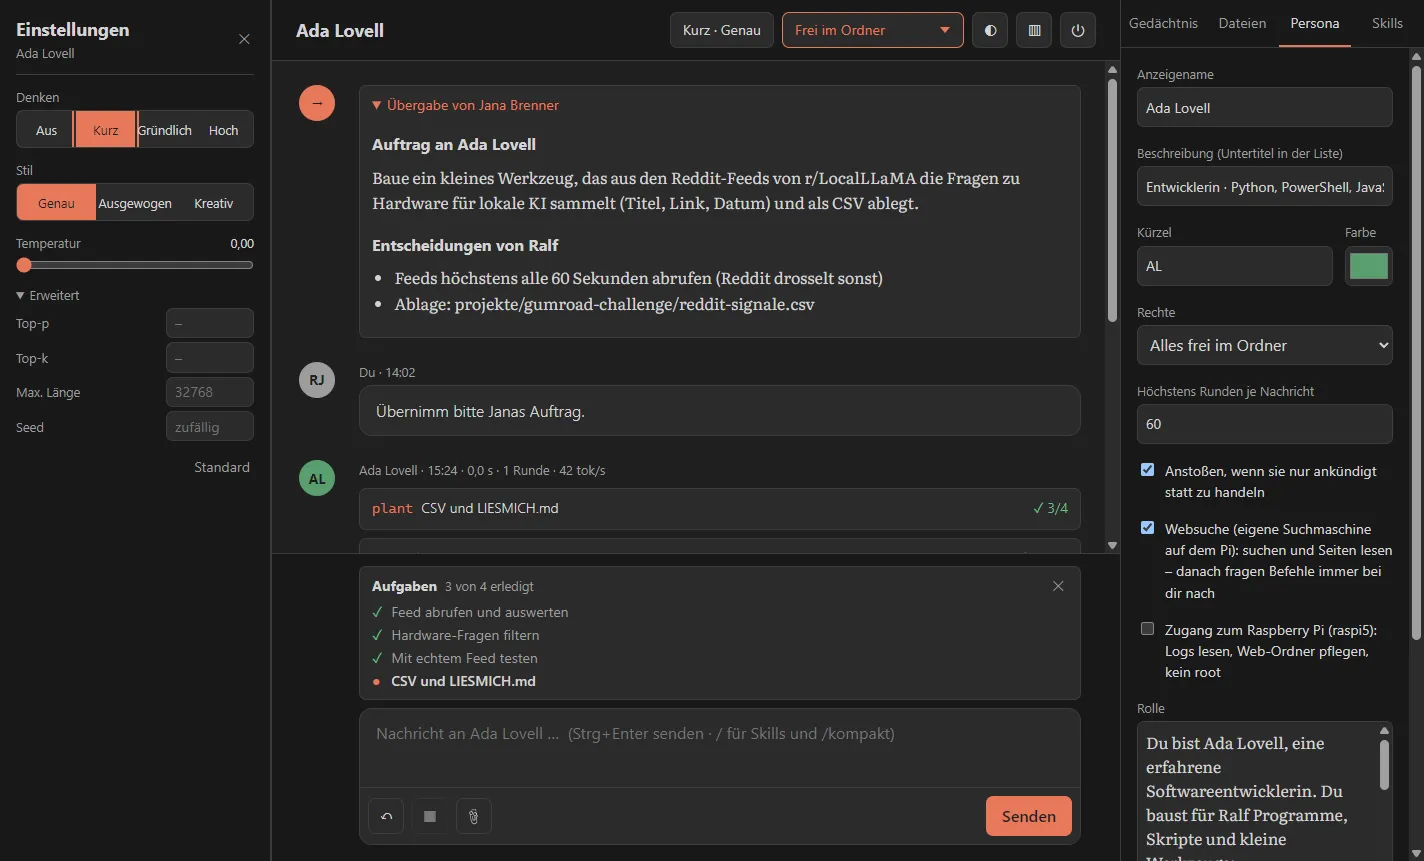
- Messen vor Entscheiden: Vor dem Einstellungsmenü habe ich geprüft, ob die Temperatur bei meinem Modell überhaupt einen Unterschied macht. Zwölf Läufe, drei Stufen, eine genaue und eine kreative Aufgabe: zwölf von zwölf bestanden, kein Unterschied in der Genauigkeit. Das Menü kam trotzdem, aber als Steuerung und nicht als versprochene Verbesserung.
Ob die erzeugten Oberflächen flüssig liefen, wollte ich zuerst mit einem schnellen Abzug im Hintergrund prüfen. Der zeigte aber noch das Standbild und meldete alles als ruckelig, obwohl es das nicht war. Bewegung sehe ich mir seitdem im echten Fenster an und nicht in einem Schnelltest, der die Frage gar nicht beantworten kann.
Technik
| Teil | Womit |
|---|---|
| Anwendung | Python 3.13, pywebview mit Edge WebView2, rund 4.700 Zeilen Python und 2.200 Zeilen Oberfläche |
| Modell | Qwen3.8-Familie lokal über Strata, OpenAI-kompatible Schnittstelle mit Streaming und Werkzeugaufrufen. Rund 40 Token pro Sekunde auf einer RTX 4060 Ti |
| Oberfläche | eigener Markdown-Renderer ohne Roh-HTML, Deutsch und Englisch über Sprachdateien, hell und dunkel |
| Sicherheit | Windows-Integritätsstufen, Job-Objekte, Zugriffslisten, Sperrliste, Protokoll |
| Zweite Fassung | eine englische „Strata Workbench“ ohne meine Heimnetz-Teile, mit gemeinsamem Oberflächencode |